 4


- AI 영상 툴들이 파편화된 인터페이스를 벗어나 상자와 선으로 데이터를 연결하는 노드 캔버스 방식으로 진화하고 있습니다.
- 배우 시트 1장과 배경 사진 3장을 노드로 고정하면 장면이 바뀌어도 인물의 얼굴과 공간 구조가 무너지지 않습니다.
- 기본 뼈대를 잡은 뒤 사본 복제와 Claude MCP 연동을 활용하여 후속 영상 제작 시간을 70분에서 20분대로 대폭 단축할 수 있었습니다.
최근 AI 영상 제작 툴 시장에서 가장 눈에 띄는 변화는 바로 노드 캔버스(Node Canvas) 방식의 도입입니다. 사진과 영상을 각각 하나의 상자(노드)로 생성하고, 이 상자들을 선으로 연결해 최종 결과물을 완성하는 구조가 새로운 표준으로 자리 잡고 있습니다.
기존 워크플로우에서는 미드저니 같은 이미지 툴에서 인물을 뽑아 다운로드하고, 런웨이나 클링 같은 영상 툴에 다시 업로드한 뒤, 음성 툴과 컷 편집 프로그램을 일일이 오가야 했습니다. 장면이 10개만 넘어가도 다운로드 폴더에서 어떤 사진이 어디에 쓰였는지 기억이 엉키기 일쑤였죠. 뉴테이크(Newtake) 같은 노드 기반 툴은 기획 메모, 스토리보드, 이미지 및 영상 생성, 오디오 편집까지 단 하나의 캔버스 화면에 모아 이 병목을 해결합니다.
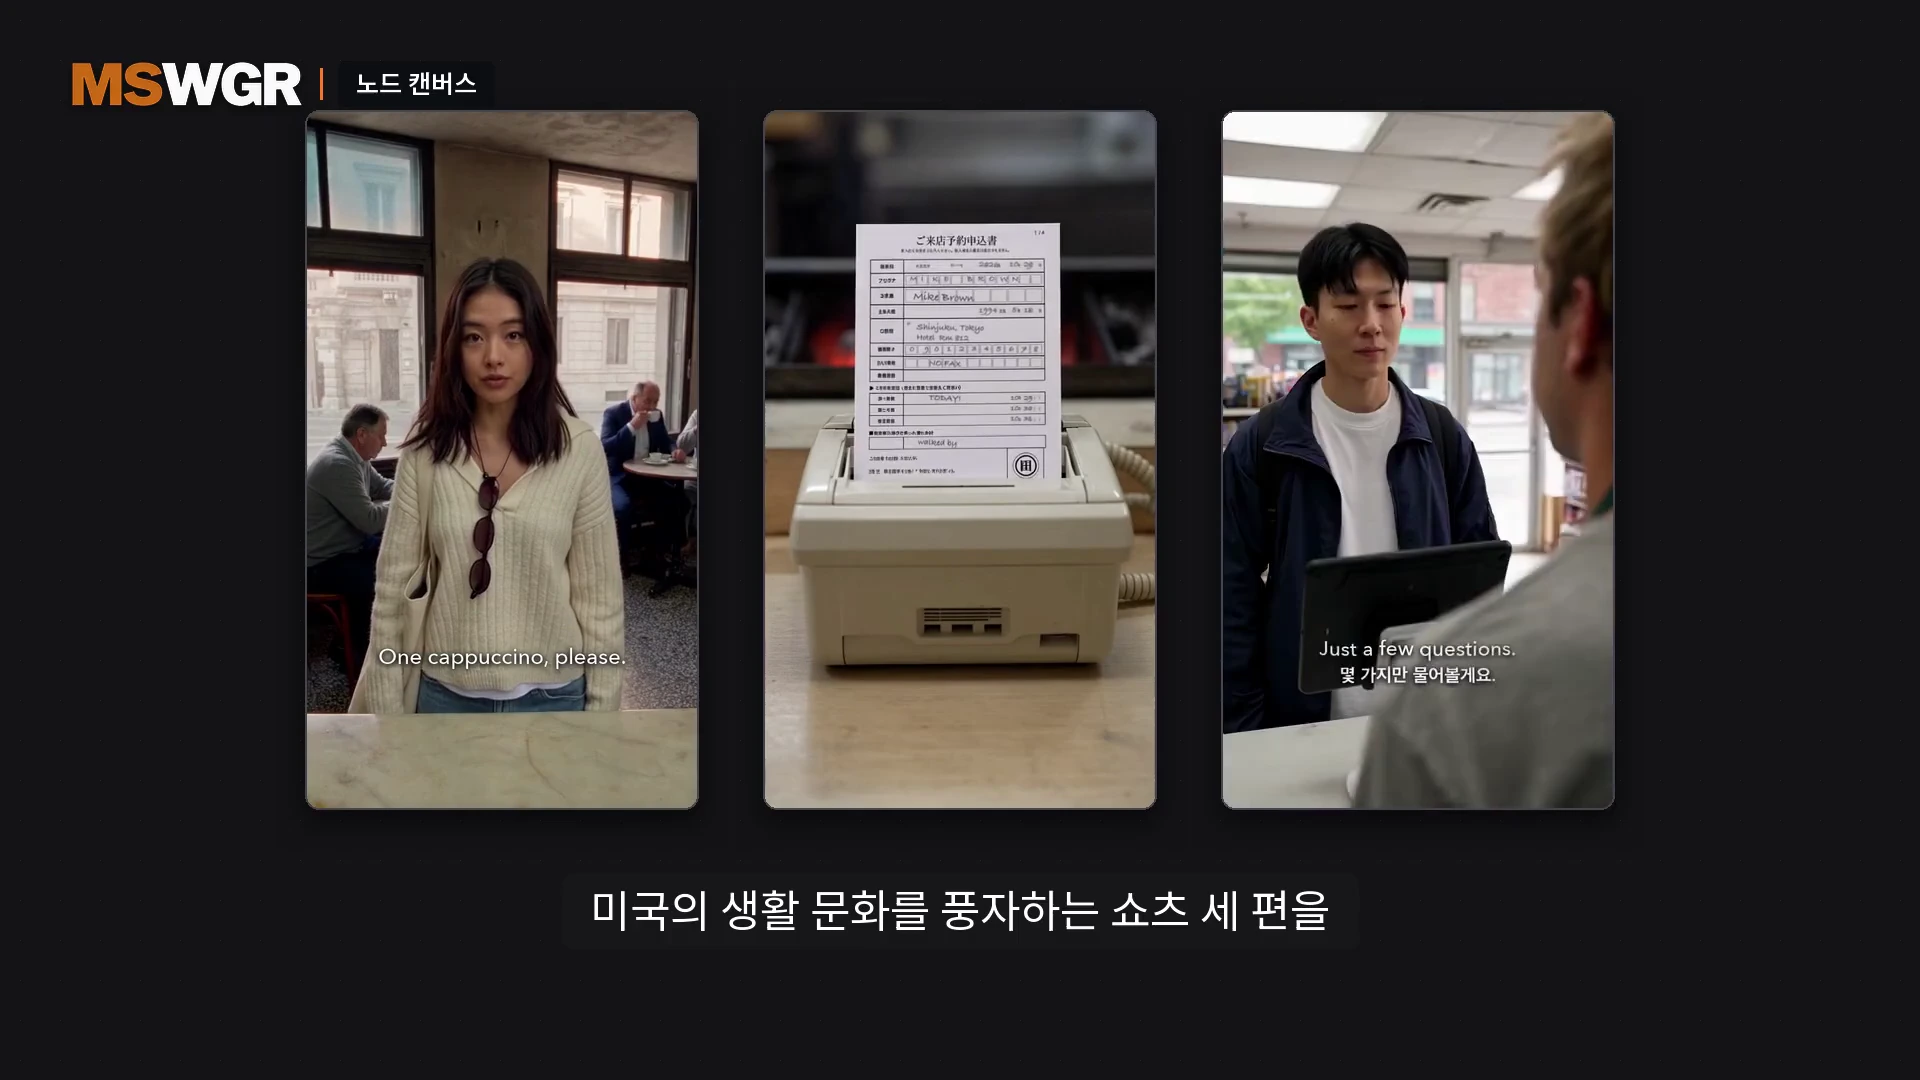
노드 캔버스 방식을 활용해 제작한 생활 문화 풍자 쇼츠 영상입니다.
노드 캔버스가 해결하는 핵심 병목: 캐릭터와 공간의 일관성
AI 영상 제작자들을 가장 괴롭혀온 문제는 바로 장면마다 얼굴과 배경이 제각각 바뀌는 일관성 붕괴였습니다. 노드 캔버스에서는 배우 사진에서 특정 장면으로 선을 이어주는 것만으로 해당 모델이 고정됩니다. 파일을 옮기는 수고와 재료를 추적하는 인지 비용을 선(Edge)이 완벽히 대체하는 셈입니다.
실제로 이탈리아 밀라노, 일본 도쿄, 미국 뉴욕의 생활 문화를 풍자하는 AI 쇼츠 3편을 같은 캔버스 위에서 제작해 보았는데요. 뼈대를 잡는 첫 편은 70분이 걸렸지만, 검증된 노드 구조를 그대로 복제해 재료만 갈아 끼운 세 번째 편은 단 20분 만에 완성되었습니다. 구조를 시각화해 둔 덕분에 시행착오가 비약적으로 줄어들었습니다.
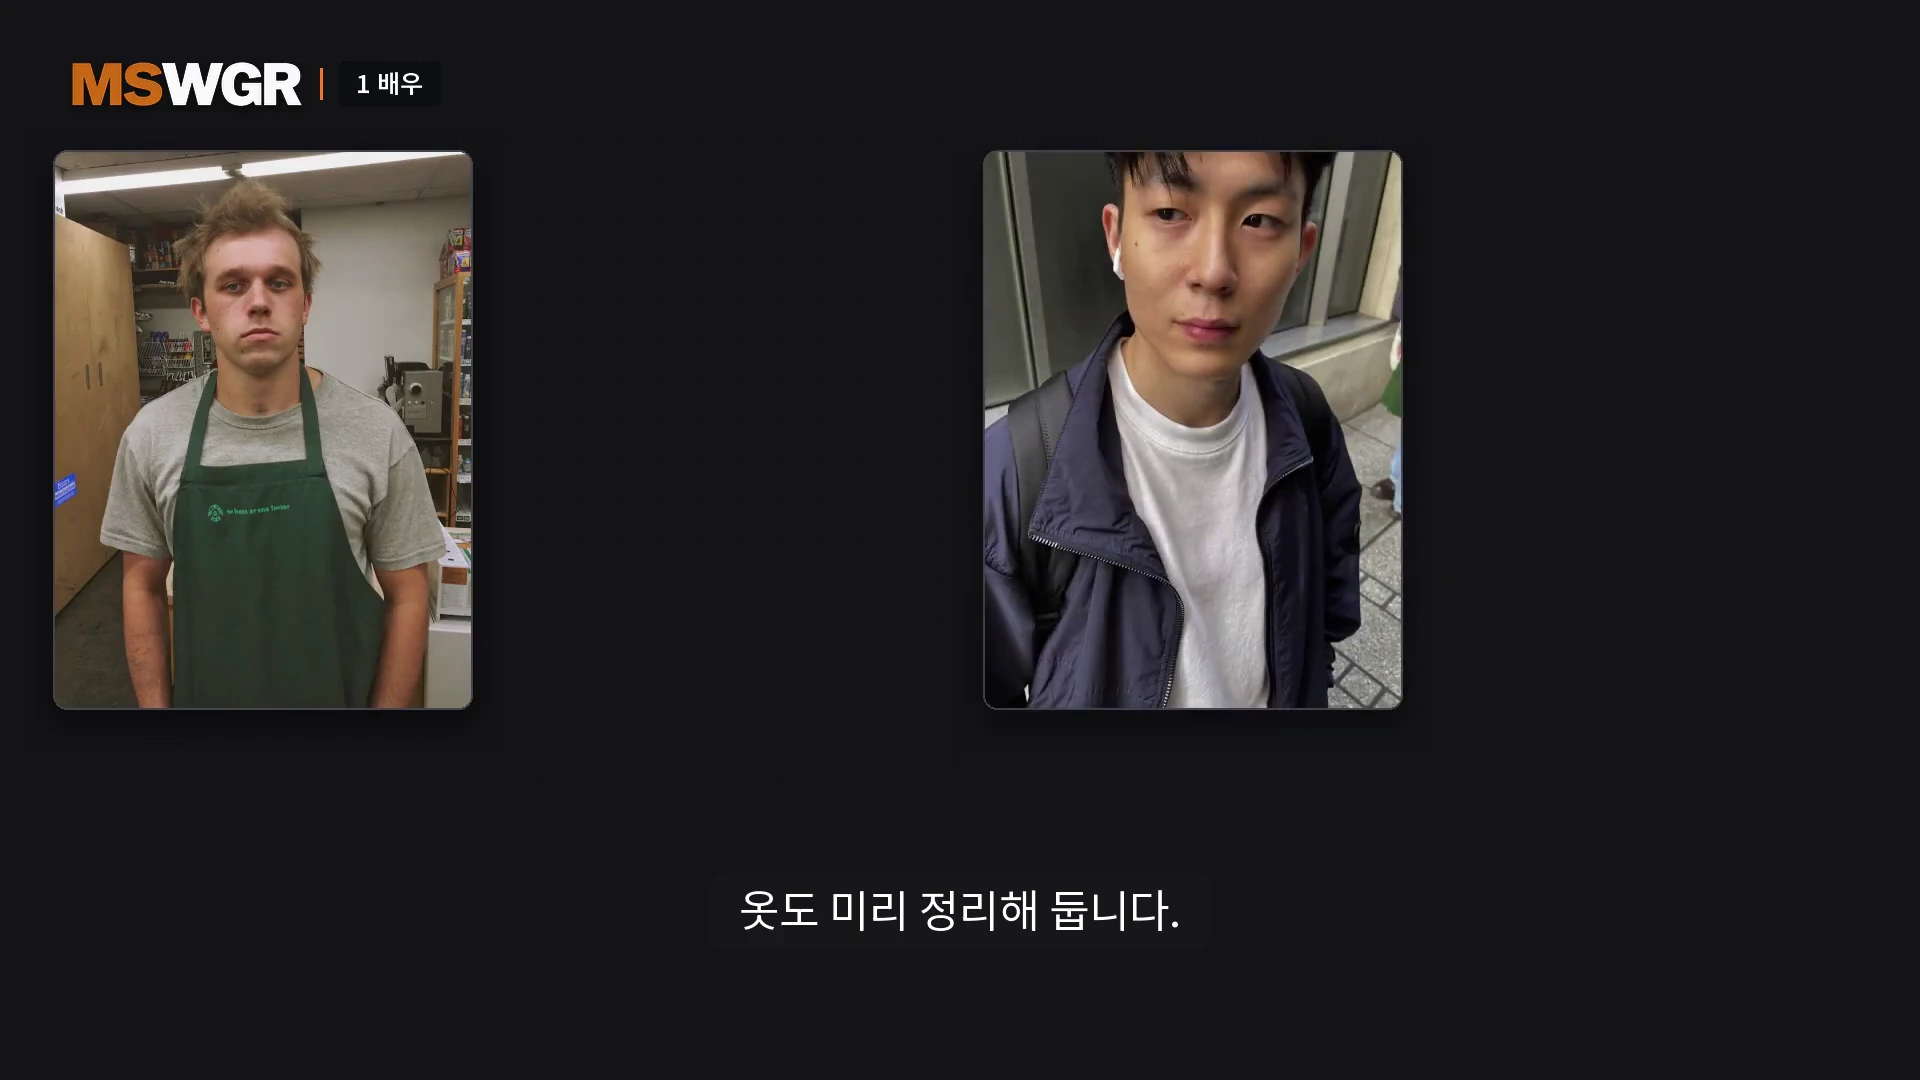
AI 영상에서 인물의 일관성을 유지하려면 시작 전 캐릭터를 명확하게 정의하는 시트 작업이 필수입니다.
일관성을 깨지 않는 3단계 노드 설계 메커니즘
노드 캔버스에서 실패 없는 영상을 뽑아내려면 세 가지 데이터 상자를 정확한 규칙으로 배치해야 합니다.
인물 상자에는 가슴 위 정면 샷과 머리부터 발끝까지의 뒷모습만 배치합니다. 정면 전신을 넣으면 작은 얼굴과 큰 얼굴이 섞여 컷마다 생김새가 변하므로 얼굴은 시트 안에 단 1회만 노출해야 합니다. 옷의 로고나 글씨, 불필요한 소품, 복잡한 배경은 회색 단색으로 완전히 지워야 노이즈가 영상으로 번지지 않습니다.
공간 상자에 사람이 섞여 있으면 그 사람이 영상에 원치 않는 엑스트라로 복제됩니다. 따라서 빈 가게 정면, 반대편 시점, 위에서 내려다본 단순 배치도 등 총 3장을 준비합니다. 이때 카운터 위의 빨간 설탕 그릇이나 팩스기처럼 눈에 띄는 기준 오브젝트를 하나 심어두면 프롬프트 한 줄로 인물이 서 있는 위치를 통제할 수 있습니다.
- 1단계: 배우는 시트 1장으로 압축
- 2단계: 장소는 사람이 없는 빈 공간 3장 구성
- 3단계: 단일 영상 안에서 멀티 컷 분할
장면을 컷마다 따로 뽑아 이어 붙이면 조명과 위치가 어긋나기 쉽습니다. 한 장소에서 벌어지는 대화라면 9~22초짜리 영상 하나를 생성하면서 프롬프트 내에 타임스탬프(예: 2.6초 와이드 샷, 4.8초 클로즈업)를 명시해 AI가 내부에서 컷을 쪼개도록 유도하는 것이 정밀도를 극대화하는 비결입니다.
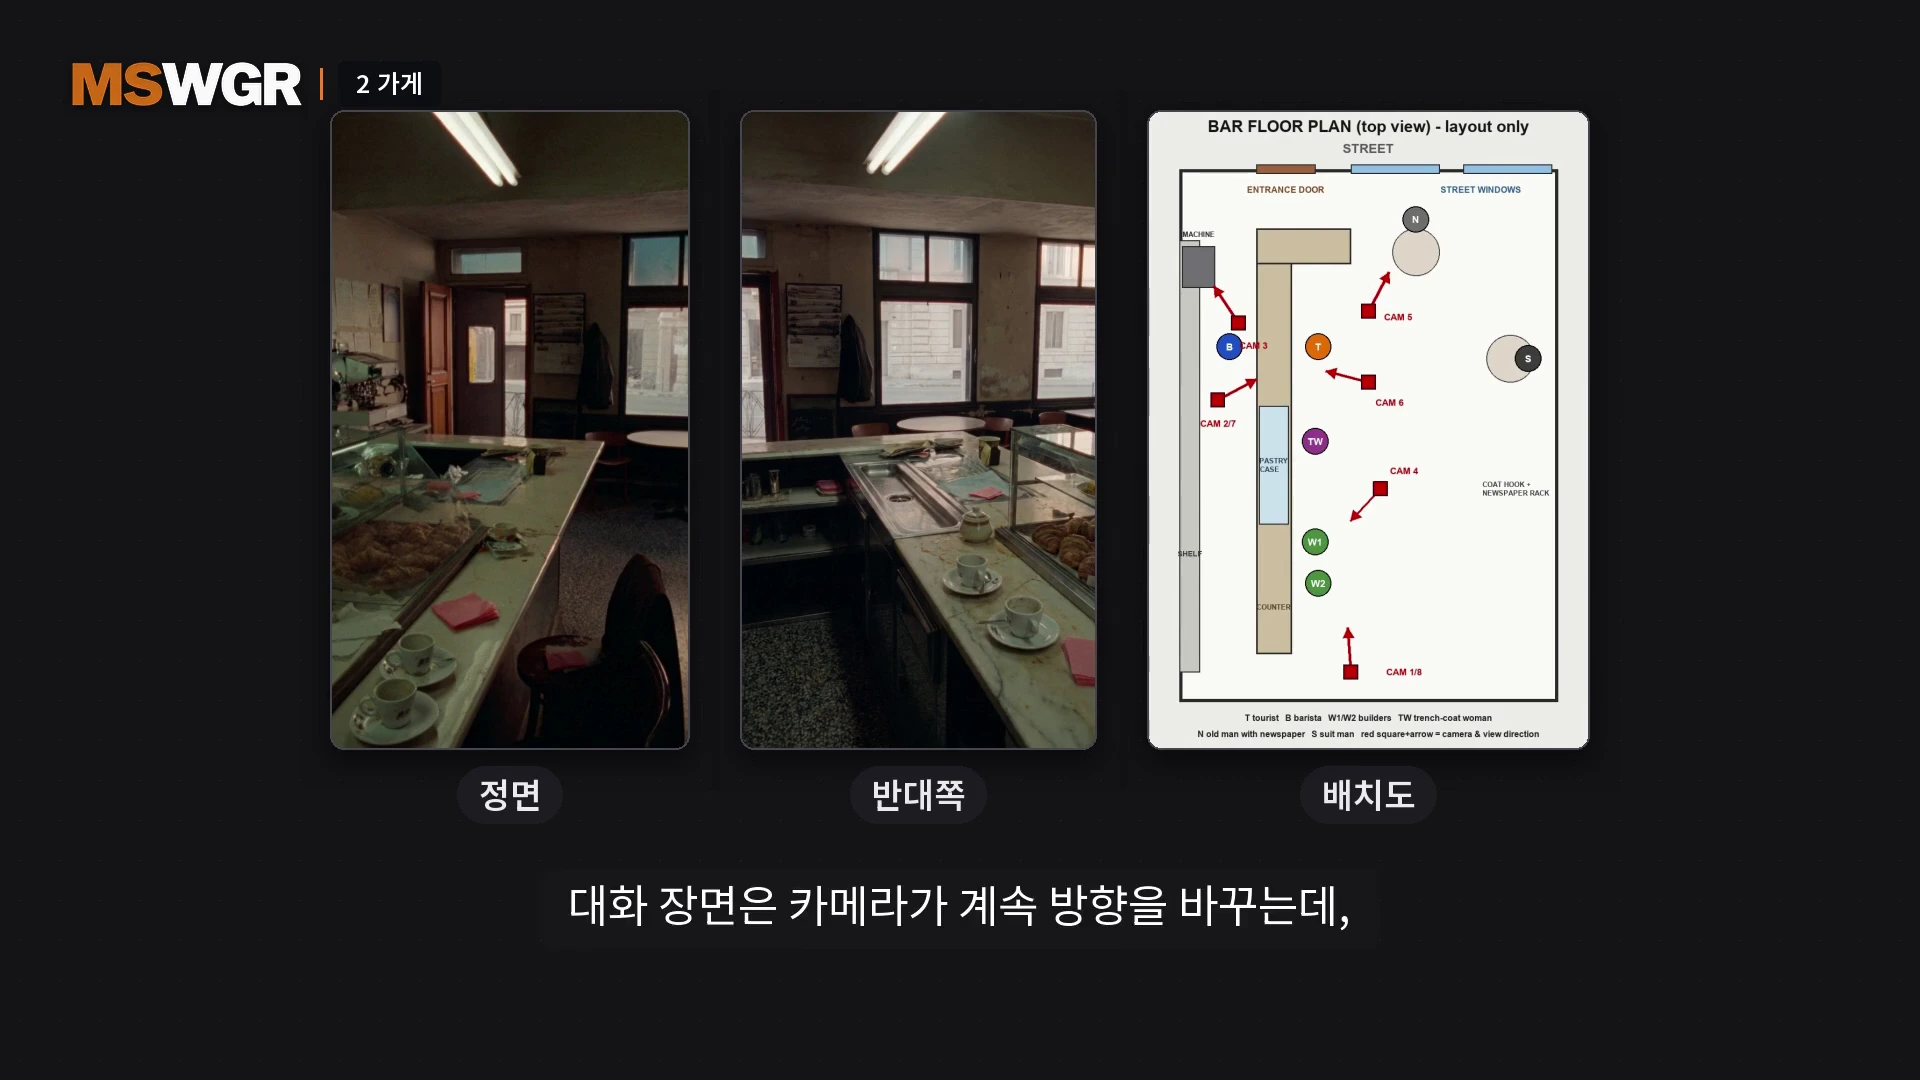
공간의 일관성을 지키기 위해 가게를 다각도로 촬영한 사진과 배치도를 활용하면, 카메라 앵글이 바뀌어도 인물과 장소의 설정을 안정적으로 유지할 수 있습니다.
오류 수정과 Claude MCP를 통한 자동화 확장
화면이 이상하게 나왔을 때 무작정 다시 뽑기를 누르면 크레딧만 낭비됩니다. 노드 방식에서는 선을 거꾸로 추적해 원인이 되는 상자 하나만 교체하면 됩니다. 벽이나 가구가 어색하면 장소 노드를, 얼굴이나 복장이 어색하면 배우 시트 노드를 수정한 뒤 선을 다시 연결하는 방식입니다.
더 나아가 뉴테이크는 MCP(Model Context Protocol)를 지원합니다. Claude 같은 LLM에 텍스트로 이야기 구조와 등장인물을 전달하면, AI가 직접 캔버스 위에 상자를 생성하고 선을 이어 프롬프트 초안까지 작성해 줍니다. 작업자는 생성된 후보를 검토하고 승인 버튼을 누르는 디렉팅에만 집중할 수 있어 생산성이 크게 향상됩니다.
앞으로 주목해야 할 실무 포인트
처음 시작하는 분들이라면 복잡한 대작 대신 배우 시트 1장, 빈 가게 2방향 사진, 9초 내외의 단일 장면으로 작은 테스트를 먼저 돌려보시길 권장합니다. 선이 재료를 어떻게 물고 다음 상자로 전달하는지 감을 잡는 순간, 영상 제작의 패러다임이 '운에 맡기는 생성'에서 '통제 가능한 시스템 설계'로 완전히 바뀌게 됩니다.
FAQ
배우 시트에 정면 전신사진을 넣지 않는 이유는 무엇인가요?
정면 전신사진 속 작은 얼굴과 상반신 초상이 한 시트에 동시에 존재하면, AI 모델이 두 얼굴 데이터를 혼합해 참조하면서 장면마다 얼굴이 미세하게 바뀌는 붕괴 현상이 발생하기 때문입니다.
화면 속 태블릿이나 간판의 글자는 어떻게 처리해야 하나요?
AI 비디오 모델은 텍스트를 정밀하게 렌더링하지 못하고 뭉개버리기 쉽습니다. 프롬프트 단계에서는 글자 없이 하얀 빛이나 빈 화면만 나오도록 통제하고, 필요한 글자는 컷 편집 단계에서 오버레이로 얹는 편이 훨씬 깔끔합니다.
Claude MCP 연동 시 완전 자동 생성을 맡겨도 되나요?
스토리보드 배치와 프롬프트 작성, 노드 연결까지는 Claude에게 맡기되, 실제 영상 렌더링 생성 버튼은 작업자가 노드 구조와 프롬프트를 최종 검토한 뒤 직접 실행해야 의도치 않은 크레딧 낭비를 막을 수 있습니다.